jueves, 2 de febrero de 2017

Los nuevos sockets de AMD para 2011. Actualizado – ProfessionalSAT

2011 va a ser un año crucial para AMD. En este año va a sacar al mercado dos nuevos sockets para sus dos micro arquitecturas de 32 nm, Bulldozer y Llano y con ello toda una colección de nuevas placas base.

IMG0031212_thumb3

Socket AM3r2 / AM3+ / AM3b – AMD Bulldozer

El primer nuevo socket será el que utilizarán las nuevas CPU Bulldozer de 32 nm, será un socket físicamente muy parecido a los actuales AM3. Su nombre será uno de estos tres:

  1. AM3r2
  2. AM3+
  3. AM3b

Veremos lo que elige el marketing de AMD.

am3 -2El nuevo socket AM3b.

AM3 AMD Bulldozer 32 nm, 8 INT cores, 4 FPUs, 4 x 2 MB L2 + 8 MB L3.

El cambio de socket para Bulldozer no sólo corresponde a razones de mercado (vender nuevas placas base) sino a cambios importantes en las controladoras de memoria integradas en el chip y sobretodo al nuevo bus Hyper Transport 3.0 con mayor ancho de banda.

HT3Roadmap del bus HT.

Socket FM1 – AMD Llano APU

Los nuevos procesadores con core gráfico Radeon integrado (APU) basados en núcleos Ontario de 32 nm llevarán el nuevo encapsulado FM1.

a4893183_s1_thumb2El nuevo socket FM1.

FM1AMD Llano 32 nm quad core, 4 L2s de 1 MB.

Lamentablemente las frecuencias de los cores K10.5 en Llano serán inferiores a las de los actuales Phenom II o Athlon II quad core. Es debido a que el consumo y disipación térmica debe tener en cuenta el core gráfico Radeon.

Se estiman frecuencias sobre los 2.4 GHz con Turbo Core. Con carga single threaded (de un núcleo) sería deseable llegar hasta los 3 GHz.

Conclusiones

Nunca en la historia AMD ha traído al mercado tres nuevas plataformas en un solo año, a principios de este 2011 llegaron las APU de bajo consumo de la serie E basadas en cores Bobcat con frecuencias hasta los 1.6 GHz.

En Junio (quizás Ontario se adelante) le seguirán Ontario y Bulldozer. AMD se la juega y ha apostado con valentía… espero por el bien del mercado y de los consumidores que tenga éxito con sus nuevos diseños.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Carlos Yus Valero – informaticapremium      informaticapremium-logo-150px[3]

Nuevo socket LGA 2011 – ProfessionalSAT

Este año 2011 se caracterizará por ser uno de los en que mayor número de nuevas plataformas y con ello nuevos sockets saldrán al mercado.

Intel nos prepara el nuevo LGA 2011 para Sandy Bridge E y AMD hace lo propio con los nuevos sockets para Bulldozer y los nuevos APU.

Intel en 2011

Definitivamente parece que se abandona el socket LGA 1356 de triple canal DDR3 (sustituto del actual  LGA 1366) y se apuesta definitivamente por el más avanzado y potente LGA 2011 de cuatro canales DDR3.

IMG0031760[1]Intel Roadmap 2011 – 2012.

En este nuevo socket Intel instalará los próximos procesadores Sandy bridge E.

A finales de este año entrarán en el mercado de sobremesa estas nuevas CPUs, sus precios empezarán sobre los 300 € para los modelos quad core y se extenderán de ahí hasta los 1000 € aproximadamente.

intel_mobo_roadmap[1]A finales de este año 2011 llegará LGA 2011.

En Q4 2011 compartirán gama con los Sandy Bridge de la serie 2600K y 2700K para sustituirlos en Q1 2012 en el momento que entrarán los nuevos Ivy Bridge de 22 nm.

Estos procesadores contarán, además de los 4 canales DDR3, con dos conexiones PCIe de 16X para GPUs y normalmente 8 DIMMs por socket. No será raro ver configuraciones con 32 GB de RAM.

Intel_Sandy_Bridge_ECPU de socket 2011.

En este mismo socket llegarán las versiones estrella de Ivy Bridge 22 nm:


ivy-features[1]

Ivy Bridge será un escalado a 22 nm de Sandy bridge con algunas mejoras menores, mayor números de cores y más cantidad de caché L3, probablemente hasta los 2.5 MB por core.

Los núcleos cambiarán poco:

  • Algunas mejoras en el procesamiento AVX y sobretodo cambios en la GPU integrada, esta vez DirectX 11, y en el hardware de coding y decoding de video (Intel Quick Sync).
  • Lo que sí será notoria será una masiva reducción en el consumo y disipación térmica desde los valores ya excelentes de Sandy Bridge.
  • También espero mejoras en la gestión y margen de frecuencia de los Turbo Modes.

En el siguiente artículo analizaré los nuevos sockets que AMD lanza este año 2011 y haré un somero análisis de los procesadores que se instalarán en ellos, AMD Bulldozer y Llano.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Carlos Yus Valero – informaticapremium      informaticapremium-logo-150px[3]

Intel Z68, el futuro X79 y Sandy Bridge E. Actualizado – ProfessionalSAT

Tras el accidentado lanzamiento de los procesadores Core i3, i5 e i7 fabricados con la nueva micro arquitectura Sandy Bridge de 32 nm, Intel va a lanzar el chipset estrella de la gama, el Z68.

intel_z68_slideIntel Z68.

Realmente, la apuesta de Intel con sus gamas de chipset H67 y P67 es, a mi modo de ver, incomprensible. Ninguno de ellos es capaz de sacar el máximo de los nuevos procesadores, para eso llega Z68.

Será el sustituto de gama alta de P67, soportando la salida gráfica de la GPU integrada estas CPUs y lo que es más importante, el ultrarrápido hardware encoding y decoding de video. Obviamente mantendrá el sencillo control de overclock implementado en P67.

17574247

Sobre el SSD caching que Intel integra en este chipset, yo personalmente no le veo interés, ya que es mucho más rápido destinar un SSD como disco de arranque del sistema operativo. Quizás para usuarios con conocimientos bajos de hardware… aunque normalmente este tipo de usuarios no compran chipsets de estas gamas…

Quedará para más adelante la inclusión de PCI Express 3.0 y USB3. Este último será incorporado con chips procedentes de otros fabricantes, normalmente NEC.

La única duda que me queda en el fondo es ver cual es el price premium que Intel cargará sobre P67…

El futuro, Intel X79 y Sandy Bridge E

El chipset de gama alta de la época será X79, que soportara los procesadores Sandy Bridge de la serie E (entusiasta) para socket 2011. Serán procesadores quad y hexa core, incluso se rumores con variantes octal core derivadas de los nuevos Xeon sin GPU integrada en 32 nm.

x79 (2)Intel X79

El socket 2011 LGA (encapsulado de CPU de 52.5 mm x 45 mm) contará con 2011 pines para un quad channel DDR3 1600… el ancho de banda de memoria es simplemente ridículo, más de 51 GB/s (12.8 GB/s X 4 canales)… sin comentarios.

Intel_Sandy_Bridge_EEn la esquina inferior izquierda vemos la CPU LGA 2011.

Las cachés L1 y L2 permanecen invariadas por core, pero se rumorean 2.5 MB de L3 por core en lugar de los 2 MB actuales.

Serán procesadores de 4, 6 y 8 cores con hasta 16 threads por chip con Hyper Threading y Turbo Mode. La caché L3 unificada llegará hasta los 20 MB.

X79Roadmap de chipsets 2011 – 2012.

Por su parte el chipset X79 no incluirá todavía soporte para USB3 de forma nativa, para ello será necesario un chip en placa base como actualmente (la mayoría de las veces NEC). Contará con 10 puertos SATA3 mas 4 SATA2 y compatibilidad SAS en 8 de sus puertos SATA.

SAS

Por fin incluirá soporte para PCI Express 3.0, será el bus de conectividad de las nuevas GPU de AMD y nVidia. con el procesador. Habrá 32 lanes para gráficos y 4 más para aumentar el ancho de banda de los periféricos de almacenamiento.

Image1Ancho de banda de PCI Espress 3.0

A Sandy Bridge y SB-E les sustituirán a finales de este año los nuevos procesadores Ivy Bridge de 22 nm. Se esperan unas prestaciones un 20% superiores a Sandy bridge y un consumo y disipación térmica muy optimizados.

Estos nuevos procesadores, de los que en 2012 veremos variante octal core en la gama de escritorio serán compatibles con el X79. Seguramente a este le seguirán los H7X y P7X para gamas de precio más bajas.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Carlos Yus Valero – informaticapremium      informaticapremium-logo-150px[3]

Intel Sandy Bridge Core i7 2600 K. Análisis X86 decoders y L0i micro op cache – ProfessionalSAT

Si vais siguiendo mis artículos, en particular este, conoceréis la nueva arquitectura de cachés que ha introducido Intel en sus nuevos procesadores Sandy Bridge. En particular, Intel ha aumentado de forma crítica el ancho de banda de las cachés L1 y L2 para alimentar correctamente a los potenciados núcleos de ejecución de enteros (INT ALU 64 bit, MMX ALU 64 bit y SSE 128 bit)  y de coma flotante (X87 FPU 64 bit, SSE 128 bit y AVX de 256 bit).

SB_uopcache2

El segundo cambio consiste en la creación de un nuevo nivel de caché de instrucciones previo a la L1i de 32 KB y 8 vías (8 ways associativity). Para ello Intel ha dotado a Sandy Bridge de una caché L0i de modesto tamaño (unas 1500 micro ops según Intel) con una tasa de aciertos efectiva sobre el 80%.

Ya traté en cierta extensión esta nueva caché L0i junto con un análisis pormenorizado de la caché L3 multibanco de 8 MB en el siguiente artículo de LowLevelHardware: Intel Core i7 2600 K. Análisis cachés L0i 6 KB y L3 unificada 8 MB – LowLevelHardware

Hay cuatro motivaciones principales para este profundo rediseño:

En primer lugar reducir el uso de los X86 decoders: y gracias a ello el consumo energético de estas gigantescas estructuras diseñadas para traducir las complejas instrucciones X86 a micro instrucciones al estilo RISC.

Como sabéis los X86 decoders tienen un gran tamaño  físico consumiendo un gran número de transistores y por ello una disipación térmica muy alta. Intel, al crear un nuevo nivel de caché de instrucciones previo al nivel 1, un nivel 0 en la práctica, se permite desactivar los decoders cuando se da un L0i hit (acierto de la micro op cache).

rmma_20110209_064736_0281Instruction cache: la L0i obtiene una increíble latencia de 2 ciclos (zona 0 – 4 KB).

Un segundo motivo es reducir la latencia media en peticiones a la caché L1i. La L0i micro op cache contiene instrucciones decodificadas, se encuentra tras los decoders y trabaja en paralelo con el resto de los pipelines de ejecución. En caso de que una secuencia de instrucciones se encuentre en la L0i (un L0i hit) Intel desactiva(obviamente según un algoritmo optimizado) la circuitería de decodificación X86 del procesador y además como beneficio obtenemos una latencia reducida como demostré en un artículo anterior.

SB_uopcache3

En tercer lugar aumentar el ancho de banda medio de fetching de instrucciones. La L1i no es capaz de transmitir 32 bytes por ciclo de modo sostenido, en cambio en caso de un L0i hit la micro op cache si lo consigue aumentando el uso de las unidades de ejecución:

SUB_rmma_20110211_124507_0187Intel Sandy Bridge SUB decode bandwidth.

SB_BranchLa micro op cache también mejora las latencias medias en caso de branch Misprediction.

Y por último reducir la longitud efectiva de los pipelines de ejecución. En caso de un L0i hit el pipeline empieza en la práctica desde la micro op cache reduciéndose en un número importante de etapas. Se consigue por ello una importante reducción en la penalización por Branch Misprediction (fallo de predicción de branches) en caso de darse un L0i hit.

Resultados de los tests. Bandwidth decode:

En este artículo presento resultados experimentales que avalan los hechos que acabo de detallar y ensalzan el excelente diseño conseguido por los ingenieros de Intel en esta gama de procesadores.

Todos los análisis se han realizado en un sistema Sandy bridge Core i7 2600K con Turbo Mode desactivado para evitar incorrecciones de medida y Windows XP Professional X64 SP2 con todas las actualizaciones al día y los últimos drivers para el chipset P67. Por cierto, las pruebas se han realizado en un stepping B1 del chipset y por ello libre del infame SATA2 bug.

Para aclarar conceptos, voy a mostrar un gráfico de ancho de banda de decodificación típico en un procesador convencional (sin micro op cache) por ejemplo un Intel Nehalem:

rmma_20081120_115543_0140Decode bandwidth en Intel Nehalem.

Esta gráfica la obtuve en Noviembre de 2008 probando los primeros Intel Core i7 920 stepping C0/C1 comerciales semanas antes de salir al mercado.

Observamos cuatro zonas con valores en bytes/ciclo claramente diferenciados:

  1. Zona 1: Caché L1i de 32 KB, desde los 1 – 32 KB.
  2. Zona 2: Caché L2 unificada de 256 KB, desde los 32 a los 256 KB.
  3. Zona 3: Caché L3 compartida de 8 MB, desde los 256 KB a los 8 MB.
  4. Zona 4: Memoria RAM, de los 8 MB en adelante. Tened en cuenta que entonces probé el sistema con un dual channel DDR3 1333 (no tenía a mi alcance 3 DIMM DDR3 con voltaje de sólo 1.65V).

Ahora veamos los resultados típicos de un core Sandy Bridge:

SUB_rmma_20110211_124507_0187

Observamos cinco zonas con valores en bytes/ciclo claramente diferenciados:

  1. Zona 1. Caché L0i micro op cache. En este caso su tamaño efectivo es de unos 2 KB. Es una caché inclusiva como es tradición en los diseños de Intel.
  2. Zona 2: Caché L1i de 32 KB, desde los 2 – 32 KB.
  3. Zona 3: Caché L2 unificada de 256 KB, desde los 32 a los 256 KB.
  4. Zona 4: Caché L3 compartida de 8 MB, desde los 256 KB a los 8 MB.
  5. Zona 5: Memoria RAM, de los 8 MB en adelante.

En primer lugar debo decir que he observado varias peculiaridades en el funcionamiento de este nuevo nivel de caché:

  • No todos los tipos de instrucciones son aparentemente cacheadas en la micro op cache. Por ejemplo, algunas instrucciones como Test son decodificadas cada vez que son encontradas en el flujo de instrucciones y las mediciones indican que son enviadas desde la L1i como en diseños anteriores:

TEST_rmma_20110211_124829_0953Intel Sandy Bridge: Test decode bandwidth.

Observamos que no hay ningún incremento de velocidad de decodificación en la zona de 1 – 6 KB, la micro op caché no cachea estas instrucciones.
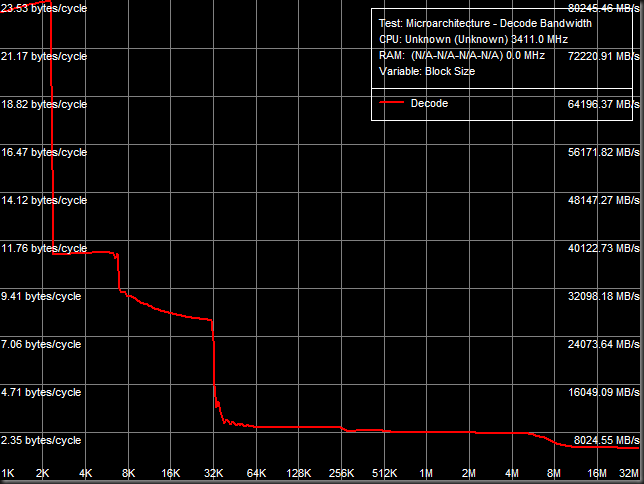
  • En cambio, en otros casos muestra una asombrosa eficacia multiplicando por más de 2 los resultados en ancho de banda de la L1i:

PrefixedCPM1_rmma_20110211_125524_0437Intel Sandy Bridge: Prefixed CMP decode bandwidth.

Si os fijáis, el tamaño efectivo medido en estos tests sitúa a la L0i sobre los 2 – 2.5 KB. En otros tests en cambio podemos llegar hasta los 6 KB, que es el tamaño “publicitado” por Intel:

PrefixedCMP4_rmma_20110211_125938_0078Intel Sandy Bridge: Prefixed CMP4 decode bandwidth.

Con instrucciones ALU Prefixed CMP4 llegamos hasta un tamaño efectivo para la micro op cache de unos 6 – 7 KB.

Conclusiones:

El diseño de un procesador actual comprende numerosos equipos diferentes trabajando en aspectos separados del diseño final. El arquitecto jefe diseña el plan general y los objetivos que debe de cumplir el nuevo producto.

Uno de los factores limitantes para el diseño de cada unidad del procesador es la superficie que ocupa. A cada una unidad se le asignan unos milímetros cuadrados (o fracciones de mm2) e incluso una morfología determinada por necesidades espaciales de unidades adyacentes.

Otra limitación reside en el consumo en reposo (idle) conocido como leakage (filtrado de corriente con los transistores en off) y en carga típica (TDP) y máxima de cada unidad del diseño. También ahí se imponen graves y rígidas restricciones.

Este último factor ha motivado la inclusión de Register Files y también de la micro op caché en Sandy Bridge, ambos persiguen un solo objetivo: una importante reducción del consumo. Todo ello motivado por la inclusión en el die de la GPU integrada, el hardware de coding – decoding de video y las nuevas unidades de proceso FPU de 256 bit AVX.

Si te gusta la cosmología o la astronomía echa un vistazo a mi artículo sobre Estructura a gran escala del universo en IdeasYCiencia.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Carlos Yus Valero – informaticapremium      informaticapremium-logo-150px[3]

Intel Sandy Bridge: Análisis de situación – ProfessionalSAT

Los nuevos procesadores Sandy Bridge están marcados desde hace escasos días por la desaparición de una plataforma estable sobre la que desplegar sus increíbles prestaciones fruto de una nueva evolución de la microarquitectura de procesadores X86 de Intel.

Actualización 13 febrero: Intel ha anunciado que mañana día 14 enviará los primeros chips B3 (corregidos) a sus partners: Intel Series 6 chipsets stepping B3 – ProfessionalSAT

Echa un vistazo a mi nuevo artículo sobre microarquitectura del procesador Sandy Bridge en LowLevelHardware: Intel Core i7 2600 K. Análisis cachés L0i 6 KB y L3 unificada 8 MB – LowLevelHardware

DSCF1075Chipset Intel P67 con el radiador retirado.

El bug en los chipsets de la Serie 6 va a costar a Intel al menos 1000 millones de dólares en gastos inmediatos, más el obligatorio desarrollo a marchas forzadas de un segundo stepping comercial posterior al defectuoso B2 y su puesta en el mercado en el tiempo mínimo imprescindible.

DSCF1070Asus P8P67 con el chipset descubierto.

Debo decir que Intel ha hecho lo que debía hacer después de conocerse la noticia aunque en mi opinión abogo por unos tests masivos de sistemas reales y con entornos software reales replicando utilizaciones típicas de usuarios finales aunque con cargas de trabajo más extremas, léase repetitivas.

Por ejemplo tests con trazas repetitivas continuas de acceso a disco en modos secuenciales y aleatorios utilizando por ejemplo el excelente Intel I/O Meter.

Sin duda con prueba similares a las apuntadas, en un periodo de tiempo razonable y con un número de sistemas reducido se puede validar con confiabilidad esta parte de la plataforma.

DSCF1071Perspectiva de la Asus P8P67 con el chipset P67 en primer plano.

Quizás se ha dado por echo que no podían haber errores en algo tan probado en generaciones anteriores de los chipset Intel como las controladoras SATA2 de 300 MB/s… un gran error.

Intel debe replantearse ahora su estrategia comercial, Sandy Bridge sigue siendo el mejor procesador actual en cualquier métrica, prestaciones absolutas o prestaciones per watt, pero necesita un nuevo lanzamiento comercial que borre la mancha que ha supuesto este fallo de diseño y el consiguiente retraso en 3 o 4 meses de su comercialización efectiva, un cuatrimestre completo.

Qué nos depara 2011

En Abril o principios de mayo estarán disponibles los chipsets corregidos de la serie 6, las gamas H67 y P67 junto con sus derivativas. Algo después surgirá el Z68, el representante de la alta gama para Sandy Bridge en socket LGA 1155.

IntelZ68El futuro Z68.

No sé si Intel decidirá mover ficha en el apartado económico y abaratar algo los procesadores o los chipsets para atraer clientes alarmados por el error en el stepping B2 del chipset. No sería nada descabellado.

Para finales de año y si no cambian los planes se esperan los procesadores hexa y octal core nativos (un solo die) sin GPU integrada y con hasta cuatro canales de 64 bit DDR3 con el nuevo socket LGA 2011. Será sin duda un procesador excepcional en todos los aspectos.

IvyBridge22nmIvy Bridge es el próximo Tick en la cadencia de Intel.

Igualmente, para finales de año espero Engineering Samples de Intel Ivi Bridge 22 nm, el sustituto de Sandy Bridge. Con un incremento en número de cores, algunas mejoras microarquitecturales menores y un aumento de caché L3.

AMD en 2011

El retraso de Sandy Bridge da un respiro a su rival, AMD, que está inmerso en la producción de dos nuevos diseños: Llano y Bulldozer, ambos fabricados en 32 nm SOI por Global Foundries.

AMD_Llano_coreDie de uno de los cores de Llano 32 nm.

Llano es una derivativa de los cores AMD K10.5 de los AMD Phenom II de 45 nm trasladada a 32 nm con bastantes mejoras en su microarquitectura e incluirá una GPU integrada de un diseño e implementación similar a la actual AMD 5650, aunque creo que el bloque UVD derivara de las Radeon 6000.

AMD_K10.6_32nmUno de los cores de 32 nm de llano junto con su L2 de 1 MB.

Lo más probable es que integre unos 400 SPs, que serán de la clásica arquitectura Vec5 de AMD / ATI. Estará dotado de dos canales DDR3 y espero una gran mejora en el terreno de la gestión de acceso a RAM, pues le va a hacer falta, sobretodo en frecuencia y load balancing.

Para un análisis más a fondo de Llano, os recomiendo mi artículo de LowLevelHardware de Julio de 2010.

Bulldozer_manipulado630Fotografía manipulada del die de AMD Orochi, el primer chip de arquitectura Bulldozer.

Sobre Bulldozer, largo y tendido he escrito sobre él en varios de mis Blogs, incluso he especulado extensamente sobre sus prestaciones:

La microarquitectura de AMD Bulldozer. Actualizado - LowLevelHardware
Intel Core i7 SMT vs. AMD Bulldozer CMT – LowLevelHardware

Cluster_multithreadingEl concepto original de CMT.

Algunos datos extra sobre AMD Bulldozer. Actualizado – ProfessionalSAT
Bulldoxer_4module_8int_cores_L3shared_630AMD octal core Zambezi 32 nm SOI.
AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

slide3[1]Prestaciones estimadas en Abril de 2009 por AMD para Interlagos.

Microarquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Bulldozer_serverAMD Bulldozer, la próxima microarquitectura.

Previo AMD Bulldozer. Actualizado – LowLevelHardware

GloFo32nmEl proceso de 32 nm va a traer muchas novedades al portafolio de CPUs de AMD.

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD_CPU_roadmap_2010Roadmap de AMD para 2011.

AMD Bulldozer – ProfessionalSAT

Modulo2Uno de los módulos de AMD Orochi, el primer integrante de la familia Bulldozer.

Conclusiones

2011 va a ser un año muy interesante pues van a legar al mercado varias microarquitecturas nuevas. En el caso de AMD, desde 2003 no nos sorprendía con un diseño de core radicalmente nuevo (desde el Athlon 64).

Ahora mismo estoy trabajando en el análisis microarquitectural de los cores de ejecución de Sandy Bridge y en su diseño de caches de datos e instrucciones.

Sobretodo me estoy centrando en la medición de latencia y anchos de banda por ciclo y en la misteriosa caché de microinstrucciones de la que ya he desentrañado algunos de sus secretos más llamativos.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Carlos Yus Valero – informaticapremium      informaticapremium-logo-150px[3]